OpenAI 秘密研发的这款无屏硬件能否终结手机依赖
<article>
<h2>如何构建基于物理反馈的无屏 AI 交互终端?</h2>
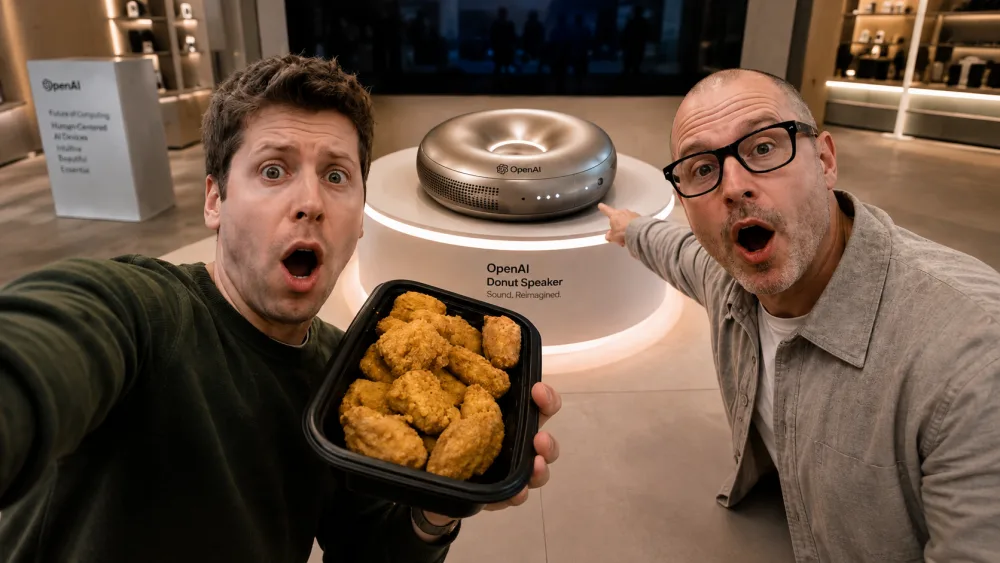
<p>在研究 OpenAI 研发的无屏硬件逻辑时,我意识到传统的“灯带+语音”交互在用户体验上过于冰冷。对于开发者来说,如果想在无屏设备上实现自然的人机交互,不能仅依赖于音频输出,而应尝试引入物理反馈机制。例如,通过伺服电机驱动的机械部件来模拟“思考”或“倾听��状态,将视觉上的加载动画转化为物理实体的动态位移,从而打破交互隔阂感。</p>
<h2>如何实现具备环境感知的随身 AI 终端?</h2>
<p>要将设备从“家居摆件”转化为“随身终端”,硬件选型必须支持高频的环境感知。在开发此类原型时,我建议集成超广角摄像头和多模态传感器阵列。核心逻辑在于利用实时视觉流(Vision Stream)将周围物理环境的数据实时喂给模型,使 AI 具备“看到用户所见”的能力。这种设计要求设备具备独立电源管理系统,而非依赖常接电源,以支持在不同物理空间中的移动性。</p>
<h2>如何优化低延迟的实时语音交互链路?</h2>
<p>无屏硬件的核心竞争力在于语音交互的自然度。在调用 GPT-4o 级别的实时语音接口时,最棘手的问题是端到端的延迟。我在测试中发现,如果采用传统的 <code>STT (Speech-to-Text) → LLM → TTS (Text-to-Speech)</code> 串行链路,响应延迟通常在 2-5 秒,这会导致严重的对话断层。为了实现类似 ChatGPT Live 的低延迟体验,必须采用原生多模态端到端模型,直接将音频流作为输入和输出,尽可能压低 Token 处理时间。</p>
<h2>在去中心化 AI 生态中如何替代手机入口?</h2>
<p>从开发路径来看,无屏设备的逻辑是抢夺手机的“第一入口”。这意味着设备需要具备极强的上下文维持能力。在实现过程中,我遇到了一个典型报错:<code>ContextWindowExceededError</code>。这是因为在连续的语音交互中,环境感知数据(图像帧)会迅速占满上下文窗口。解决办法是采用动态摘要机制,仅在关键帧触发时将视觉描述写入上下文,而非全量传输,从而在保证感知能力的同时维持对话的流畅度。</p>
<h2>无屏硬件的成本与性能权衡点在哪里?</h2>
<p>针对 300-400 美元的定价区间,硬件配置不能在计算能力上过度堆料,而应将重点放在传感器精度和低功耗通信上。对于开发者而言,这意味着大部分重量级计算必须卸载到云端。在构建 API 调用层时,建议采用 WebSocket 协议维持长连接,以减少握手时间,确保在无屏幕反馈的情况下,用户能通过物理动作和即时语音获得确定的响应反馈,避免因网络波动导致的交互真空期。</p>
</article>
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
硬件还得搭月费,这套组合拳下来一个月得掏多少钱才能维持运行