别再把 Temperature 当成大模型的灵感开关了
很多开发者和 Prompt 工程师在面对模型输出过于死板时,习惯性的操作就是把 Temperature(温度)往上调,潜意识里认为这能给模型注入“创意”。但实际上,这种认知在底层逻辑上是个误区。Temperature 改变的是概率分布的平滑度,它本质上是在增加随机性,而不是在创造逻辑上的灵感。
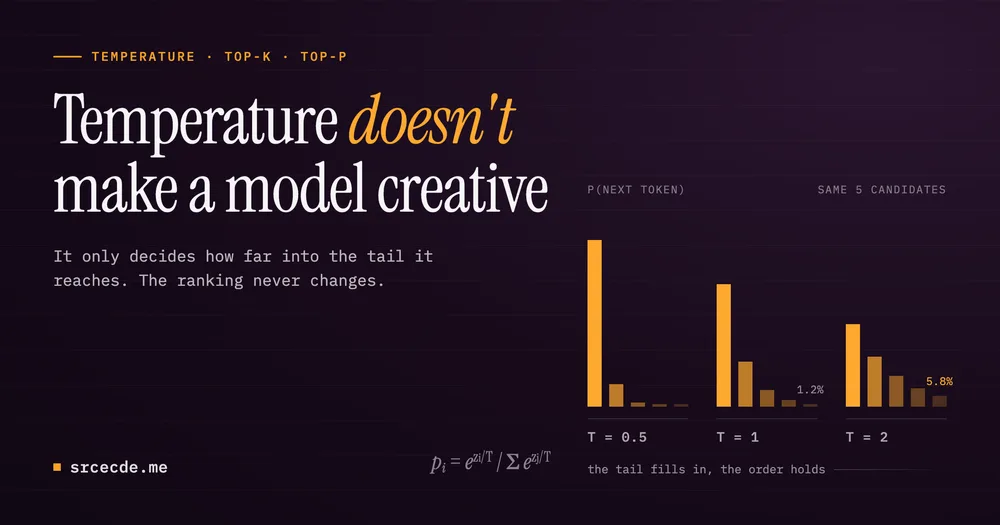
要理解这一点,得看模型预测下一个 Token 的过程。在 Softmax 层之前,模型会输出一组 Logits(原始分数)。Temperature 的作用其实非常简单,就是在这组分数上做一次除法。
我们可以看一组具体的数字:假设模型预测下一个词时,词 A 的 Logits 是 2.0,词 B 是 1.0,词 C 是 0.1。如果你设置 Temp = 0.5,那么 Logits 会变成 [4.0, 2.0, 0.2],词 A 的领先优势被极度放大,模型几乎必然选择词 A,输出结果极其稳定。而如果你把 Temp 调高到 2.0,Logits 则变成了 [1.0, 0.5, 0.05],词 A 依然是最大值,但它与词 B、词 C 的差距缩小了。
这里就是关键所在:无论温度如何波动,词 A 的概率永远高于词 B。温度高了,只是让那些原本概率较低的词有了被抽中的机会,这在数学上叫“分布扁平化”,在体感上叫“随机性增加”。当你发现模型在 Temp = 1.5 时写出了一些奇怪的词,那不是它突然有了创意,而是它在概率分布的边缘随机抽到了一个低概率词。
在实际调优中,很多人会将 Temperature 与 Top-k 和 Top-p 混淆。其实这三者的分工完全不同:
Temperature 是在做“缩放”。它决定了概率分布的陡峭程度。低温度导致分布陡峭(确定性高),高温度导致分布平缓(随机性高)。
Top-k 是一个“硬截断”。它直接在排名上划线,比如设置 k=50,那么概率排名 51 之后的词无论温度怎么调,都被直接扔掉。这能有效防止模型在高温状态下抽到完全不相关的离群词,导致输出崩坏。
Top-p(核采样)则是“动态截断”。它不看排名数量,而是看累积概率。如果前 3 个词的概率之和就已经达到了 p=0.9,那么剩下的所有词都会被剔除。这比 Top-k 更灵活,因为在模型非常确定时,候选集会自动缩小;在不确定时,候选集会自动扩大。
如果你在实操中发现模型输出重复,或者完全不按逻辑出牌,不要死磕这些采样参数。因为这些参数是在“结果”阶段做抽样,而不是在“思考”阶段引导逻辑。
一个切实有效的替代方案是优化提示词工作流。如果你需要多样化的方案,与其将 Temperature 调到 1.2 导致模型胡言乱语,不如在 Prompt 中明确要求:“请从产品经理、架构师和最终用户这三个截然不同的视角,分别提供三种不同的解决方案”。这种通过指令引导的“多样性”是基于逻辑分支的,而调高温度带来的“多样性”仅仅是基于概率抽样的随机性。
总结来说,Temperature 只是在概率分布的边缘做文章,它能让输出变得“不可预测”,但不能让模型变得“更聪明”。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
把Temperature拉到1.5直接就成乱码生成器了,简直是给模型喂了迷药
赶紧配合Top-P把范围压住,不然数值太高直接就崩给看